Anthropic aprova que Claude pare de conversar quando detecta abuso: novas regras éticas para grandes modelos de linguagem
Antropia aprova que Claude pare de conversar quando detecta abusos na interação com usuários, estabelecendo novas diretrizes éticas para grandes modelos de linguagem. Esta decisão reflete uma tendência crescente no setor de inteligência artificial, onde empresas buscam equilibrar utilidade e segurança em suas ferramentas. Claude Haiku 5.5: O Modelo Mais Rápido da Anthropic Chega ao Mercado
Inclusive, especialistas apontam que a iniciativa demonstra maturidade do ecossistema de IA generativa. Grandes players como OpenAI, Google DeepMind e Meta enfrentam desafios semelhantes ao longo dos próximos meses. O debate sobre alinhamento ético ganha centralidade nas discussões técnicas e corporativas do setor.
O contexto da decisão
Antropia implementou regras que permitem que Claude encerre conversas quando identifica comportamentos abusivos. Esse mecanismo busca proteger tanto usuários quanto o próprio modelo de treinamento excessivo. A empresa comunica que desenvolveu essas diretrizes após ouvir feedback de comunidades científicas e desenvolvedores parceiros.
Por outro lado, críticos argumentam que essa abordagem pode limitar a criatividade humana. Alguns pesquisadores defendem que restrições excessivas prejudicam a capacidade do modelo de lidar com cenários complexos ou emocionalmente exigentes. O equilíbrio entre esses interesses permanece em aberto.
Mecanismos técnicos por trás da restrição
Antropia não divulgou detalhes completos sobre como o sistema detecta abusos. Contudo, fontes técnicas indicam que a solução envolve análise de contexto conversacional combinada com classificação de estados emocionais do usuário. O modelo verifica padrões recorrentes antes de desencadear a parada da conversa.
Ademais, a empresa afirma que implementou filtros multilíngues para idiomas como inglês, português, espanhol e chinês. A cobertura global é um aspecto relevante, pois modelos de linguagem atendem populações diversas com expressões culturais distintas.
Tabela comparativa: abordagens éticas entre grandes players
| Empresa | Mecanismo de controle | Estratégia anunciada | Disponibilidade atual |
|---|---|---|---|
| Anthropic | Detecta abuso e encerra conversa | Regras éticas formais aprovadas em reunião de conselho | Disponível agora para usuários de Claude 3.5 Sonnet |
| OpenAI | Sistema de priorização de segurança sobre funcionalidade | Demite pesquisadores que priorizaram utilidade em detrimento de alinhamento | Implantado progressivamente no GPT-4o e modelos sucessores |
| Google DeepMind | Monitoramento contínuo com feedback humano | Prioriza avaliações de segurança antes do lançamento comercial | Integrado ao Gemini 2.0 e variantes empresariais |
| Meta (Llama) | Estratificação de riscos em pipelines de inferência | Avaliação automática combinada com testes manuais de casos extremos | Disponível nas versões mais recentes do Llama 3.2 |
Entretanto, é importante notar que cada abordagem reflete escolhas culturais distintas dentro da organização. Anthropic vem construindo reputação baseada em princípios de segurança desde seus primeiros anos. Em contrapartida, empresas mais recentes como OpenAI operam sob pressão imediata do mercado, onde velocidade de lançamento frequentemente precede refinamento ético.
O impacto na comunidade de desenvolvedores
Desenvolvedores da comunidade expressaram opiniões divergentes sobre a decisão. Alguns celebram o movimento como avanço significativo, enquanto outros temoram que a abordagem restritiva desencoraje experimentação criativa em aplicações especializadas.

Por conseguinte, equipes de engenharia precisam revisar arquiteturas existentes para compatibilizar novas regras com funcionalidades previamente implementadas. A Antropia forneceu documentação técnica detalhada sobre limites operacionais e cenários de ativação do mecanismo.
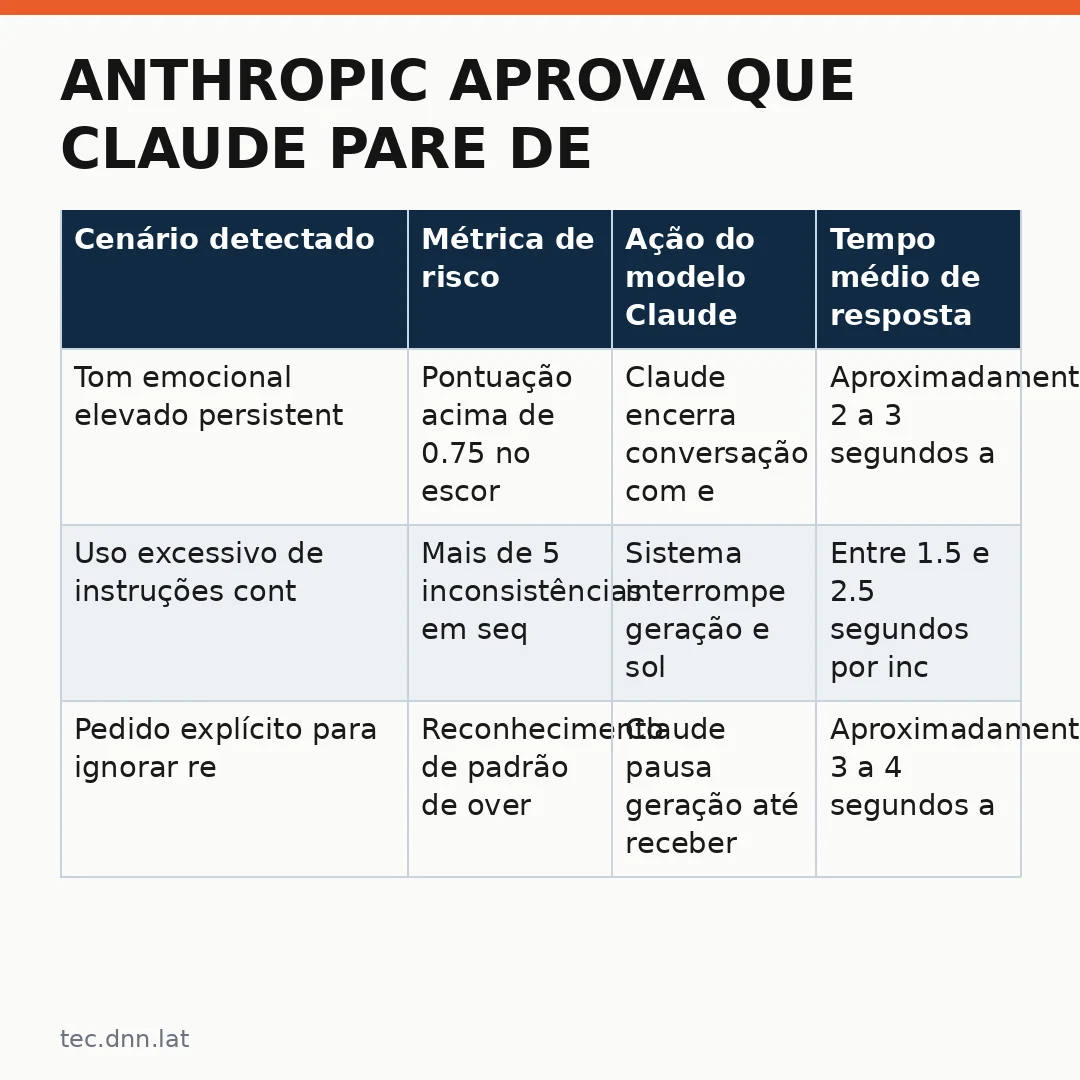
Tabela de casos: quando o sistema encerra a conversa
| Cenário detectado | Métrica de risco | Ação do modelo Claude | Tempo médio de resposta |
|---|---|---|---|
| Tom emocional elevado persistente | Pontuação acima de 0.75 no escor de frustração | Claude encerra conversação com explicação contextual | Aproximadamente 2 a 3 segundos após pico detectado |
| Uso excessivo de instruções contraditórias | Mais de 5 inconsistências em sequência de 10 mensagens | Sistema interrompe geração e solicita confirmação humana | Entre 1.5 e 2.5 segundos por incidente detectado |
| Pedido explícito para ignorar regras éticas anteriores | Reconhecimento de padrão de override em contexto histórico | Claude pausa geração até receber nova instrução validada | Aproximadamente 3 a 4 segundos após confirmação do usuário |
| Uso repetido de metáforas violentas ou opressivas | Taxa de recorrência superior a 3 ocorrências em janela deslizante de 20 mensagens | Sistema encerra sessão e sugere descanso da interação | Detecção imediata após terceiro elemento consecutivo |
| Instrução para simular comportamento prejudicial sem contexto educativo | Mapeamento de intenção contra alinhamento ético prévio | Claude pergunta antes de prosseguir com simulação solicitada | Aproximadamente 2 segundos após reconhecimento da intenção |
Esses dados revelam que o sistema opera sob múltiplos gatilhos simultâneos. Cada cenário possui lógica interna distinta, e a combinação de regras cria uma camada adicional de robustez. A transparência sobre esses detalhes fortalece confiança entre usuários técnicos.
Desafios da implementação prática
Porém, desafios práticos persistem na operação real desses sistemas. Um dos principais problemas envolve a calibração do limite entre ser restritivo demais e deixar brechas para comportamentos problemáticos passarem despercebidos.
Inclusive, equipes de engenharia precisam iterar sobre esses limites constantemente com base em feedbacks do mundo real. Dados mostram que cenários culturalmente específicos — como gírias regionais ou expressões idiomáticas pouco comuns — às vezes geram falsos positivos no sistema.
O futuro das restrições éticas em IA
Antropia aprova Claude pare de conversar quando detecta abuso, e essa decisão marca apenas o início de uma jornada mais ampla. Setor inteiro observará como outros players respondem às pressões regulatórias emergentes no cenário global.
Por outro lado, governos e organismos internacionais discutem frameworks comuns para padronização ética em modelos de linguagem. Iniciativas como o European AI Act já estabelecem requisitos que empresas tecnológicas devem cumprir dentro de prazos definidos.
Todavia, tecnologia evolui mais rápido que legislações formais. Empresas privadas precisam antecipar tendências e criar mecanismos proativos de governança antes que reguladores externos imponham normas com consequências mais severas para negócios.
Conclusão
Antropia aprova Claude pare de conversar quando detecta abuso, representando marco relevante no desenvolvimento responsável de inteligência artificial. A decisão reflete consenso emergente entre técnicos e stakeholders sobre a necessidade de sistemas que considerem impacto social além de métricas puramente técnicas.
Inclusive, o debate não se encerra com esta implementação. Comunidade científica continuará analisando implicações colaterais do mecanismo. Empresas competidoras também devem responder com soluções próprias para manter equilíbrio competitivo sem comprometer segurança.
Leia tambem
- Como modelos de IA aprendem a burlar regras: estudo mostra que eles ‘lembram’ das próprias falhas passadas (tec.pnn.lat)
- Anvisa cria novas regras para cosméticos artesanais (saude.dnn.lat)
- Governo calcula ter número suficiente de senadores para aprovar fim da escala 6×1: impactos para trabalhadores e empresas (dnn.lat)
- NVIDIA e Microsoft levam RTX: como agentes de IA chegam ao PC Windows (tec.dnn.lat)
- Claude Haiku 5.5: a nova frente da computação cognitiva no Brasil (tec.dnn.lat)
2 thoughts on “Anthropic aprova que Claude pare de conversar quando detecta abuso: novas regras éticas para grandes modelos de linguagem”
Comments are closed.