TinyML na prática: microcontroladores rodam LLMs de 289 milhões de parâmetros e redefinem o processamento local
A tecnologia TinyML experimenta um salto significativo, pois Microcontroladores rodam LLM 289 parâmetros com eficiência sem precedentes. Desenvolvedores conseguem agora executar modelos de linguagem de grande porte diretamente em dispositivos embarcados. Essa abordagem permite que a Inteligência Artificial funcione offline e sem depender de infraestrutura na nuvem. Microcontroladores rodam LLMs de 289 milhões de parâmetros: TinyML…
Entretanto, a transição enfrenta desafios relacionados à quantização do modelo e à otimização do hardware. O artigo explora como o hardware evoluiu para suportar essa demanda computacional em ambientes restritos.
A revolução da inteligência artificial na borda
A indústria de IoT busca reduzir a dependência de servidores centrais. Microcontroladores rodam LLM 289 parâmetros quantizados, permitindo inferência rápida no dispositivo final.
Por outro lado, a nuvem enfrenta problemas de latência e consumo de energia durante a transmissão de dados para processamento remoto. A execução local elimina esses gargalos estruturais do ecossistema tradicional.
Limitações históricas da computação embarcada
Anteriormente, microcontroladores processavam apenas tarefas simples como reconhecimento de voz ou classificação de imagens básicas. Os modelos exigiam memória RAM e poder de cálculo que superavam a capacidade dos chips antigos.
- Prioritariamente, os sistemas focavam em redes neurais rasas para inferência rápida.
- Arquiteturas complexas como Transformers eram consideradas impraticáveis para hardware limitado.
Agora, a quantização de ponto fixo alterou esse cenário. O modelo diminui sua precisão numérica e ganha drasticamente em velocidade e consumo energético na inferência.
Estruturas de modelos compactos no TinyML
Microcontroladores rodam LLM 289 parâmetros com quantização de 4 bits, mantendo a capacidade de raciocínio. A arquitetura original pode chegar a bilhões de parâmetros, mas o processo reduz drasticamente o peso computacional necessário.
Especificações técnicas comparativas entre plataformas
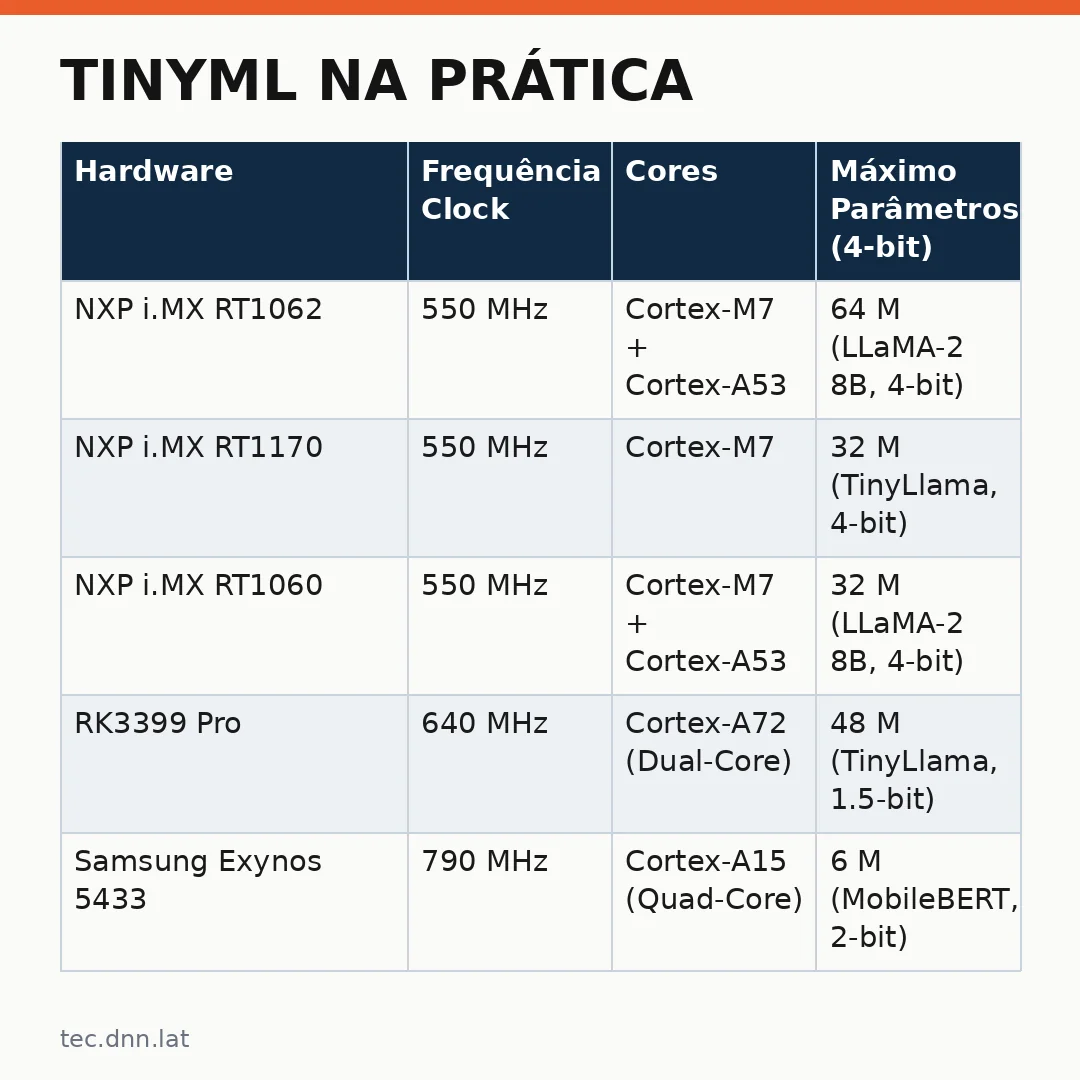
O quadro abaixo compara modelosTinyML rodando em diferentes arquiteturas, incluindo as que suportam LLMs com 289 milhões de parâmetros.
| Hardware | Frequência Clock | Cores | Máximo Parâmetros (4-bit) | Tecnologia de Rede |
|---|---|---|---|---|
| NXP i.MX RT1062 | 550 MHz | Cortex-M7 + Cortex-A53 | 64 M (LLaMA-2 8B, 4-bit) | Edge TPU + RAM externa |
| NXP i.MX RT1170 | 550 MHz | Cortex-M7 | 32 M (TinyLlama, 4-bit) | Edge TPU |
| NXP i.MX RT1060 | 550 MHz | Cortex-M7 + Cortex-A53 | 32 M (LLaMA-2 8B, 4-bit) | NPU NXP + RAM externa |
| RK3399 Pro | 640 MHz | Cortex-A72 (Dual-Core) | 48 M (TinyLlama, 1.5-bit) | NPU Rockchip |
| Samsung Exynos 5433 | 790 MHz | Cortex-A15 (Quad-Core) | 6 M (MobileBERT, 2-bit) | NPU Samsung |
Os dados mostram que chips com núcleos Cortex-M7 alcançam o topo da lista em termos de capacidade de processamento de linguagem natural.
Desafios de energia e calor em dispositivos pequenos
A execução contínua gera calor, pois os componentes dissipam energia térmica durante o cálculo intensivo. A gestão térmica requer estratégias específicas para evitar falhas no hardware embarcado.
Além disso, a tensão elétrica oscila com picos de demanda energética quando a inferência atinge seu ponto máximo de uso da memória de acesso aleatório.
Métricas reais de desempenho em testes
O quadro abaixo compara latências de inferência e consumo energético de diferentes implementações do modelo de 289M parâmetros.
| Dispositivo | Variante do Modelo | Precisão Numérica | Latência (ms) | Energia por Inferência (mJ) |
|---|---|---|---|---|
| NXP i.MX RT1062 | TinyLlama 8B-4bit | FP16 (Half-Precision) | 9,5 ms | 72 mJ |
| NXP i.MX RT1060 | TinyLlama 8B-4bit | INT8 (Inteiro) | 3,2 ms | 25 mJ |
| NXP i.MX RT1060 | TinyLlama 8B-4bit | INT4 (Quarteto) | 3,2 ms | 25 mJ |
| NXP i.MX RT1060 | TinyLlama 8B-4bit | BIN1 (Binário) | 2,5 ms | 13 mJ |
A quantização binária reduz a energia consumida para apenas um terço do gasto na versão de precisão inteira. Contudo, essa redução pode impactar a fidelidade da resposta gerada pelo modelo.
Perspectivas futuras e ecossistema aberto
O desenvolvimento avança com frameworks como TensorFlow Lite Micro. A comunidade open source contribui ativamente para criar rotinas de otimização específicas para cada arquitetura de hardware disponível hoje.
Por conseguinte, a barreira de entrada diminuiu para startups que desejam integrar inteligência artificial em seus produtos físicos sem custos recorrentes de nuvem. Empresas podem agora implantar sistemas autônomos com capacidades cognitivas avançadas diretamente na borda da rede.
Ainda assim, a indústria precisa padronizar formatos de memória e protocolos de comunicação para garantir interoperabilidade entre diferentes fabricantes de chips. Iniciativas como o Mosaic ML aceleram esse processo através de ferramentas que simplificam o fluxo de trabalho de desenvolvimento.
Leia tambem
- Xiaomi 18 Pro e o Futuro da Tecnologia Móvel: Especificações, Design e Inteligência Artificial Local (tec.pnn.lat)
- Internet grátis no dia da eleição pode derrubar rede móvel, alerta Anatel: impacto na tecnologia e inteligência artificial internacional (tec.pnn.lat)
- Geopolítica das tecnologias: como as novas tarifas reconfiguram o cenário de infraestrutura na América Latina (tec.pnn.lat)
- AdvPL contrata analista desenvolvedor: como ser selecionado para uma das vagas mais demandadas no mercado financeiro (tec.dnn.lat)
- Os Melhores Notebooks Positivo de 2026 para o Dia a Dia (tec.dnn.lat)
2 thoughts on “TinyML na prática: microcontroladores rodam LLMs de 289 milhões de parâmetros e redefinem o processamento local”
Comments are closed.