Pipelines de dados e linhagem: o que sustenta um agente de IA preciso na AWS — guia para quem implementa no negócio
A frase Pipelines dados linhagem sustenta, a base de qualquer sistema de inteligência artificial que almeja precisão no mundo empresarial. Quando uma organização decide implementar agentes de IA em escala, o investimento inicial muitas vezes foca nos modelos preditivos e na infraestrutura computacional. Contudo, poucos percebem como os mecanismos de ingestão, processamento e rastreabilidade dos dados funcionam como alicerce invisível que define o valor real daquela solução tecnológica. A AWS oferece uma suíte robusta para construir esses fluxos, mas é preciso entender cada componente para evitar armadilhas que geram custos ocultos ou falhas operacionais no futuro. Como gravar, transcrever e resumir reuniões com inteligência…
A implementação bem-sucedida exige planejamento prévio. Sem um desenho claro de como as informações circulam entre sistemas legados e novas fontes digitais, o agente de IA opera em modo cego. A AWS dá suporte a essa arquitetura com ferramentas integradas que reduzem drasticamente o tempo de entrega. Por outro lado, negligenciar a linhagem durante o desenvolvimento leva à perda total da confiança nos resultados gerados pelo modelo artificial.

Por que pipelines robustos são essenciais para agentes de IA
Um agente de inteligência artificial precisa receber dados em tempo real ou quase isso. Pipelines mal dimensionados criam gargalos que tornam as decisões do sistema lentas e ineficientes. Além disso, quando há múltiplos fornecedores integrados à plataforma da nuvem, a gestão das conexões se torna complexa. A AWS oferece opções como Glue para orquestração ETL e Kinesis para captura de eventos em tempo real.
A diferença entre um pipeline bem feito e um que falha está na disciplina com que cada etapa é documentada. Por exemplo, quando uma fonte externa passa por alteração de formato, o pipeline deve notificar imediatamente quem depende daquela informação. Esse mecanismo de aviso evita que o agente produza relatórios distorcidos ou tome decisões equivocadas no negócio.
Em contrapartida, pipelines frágeis geram um efeito dominador: pequenos erros se multiplicam ao longo das transformações até chegar à camada final da aplicação. A AWS oferece ferramentas de monitoramento que detectam anomalias antes que elas impactem o usuário final. Todavia, esses recursos exigem configuração adequada e conhecimento técnico específico.
Linhagem de dados: rastreabilidade como requisito de conformidade
A linhagem descreve a jornada completa de cada ponto de dado desde sua origem até seu consumo final. Quando um agente de IA toma uma decisão importante, é possível rastrear quais linhas originais influenciaram aquela escolha. Essa capacidade é mandatória para setores que precisam comprovar conformidade regulatória, como finanças e saúde.
A AWS possui serviços nativos que facilitam essa implementação sem exigir que o desenvolvedor construa cada componente manualmente. Glue DataBrew e Lake Formation oferecem recursos de catalogação que se integram com os fluxos de processamento existentes. Ademais, essas soluções fornecem relatórios visuais que simplificam a explicação para stakeholders não técnicos.
Por exemplo, um relatório financeiro gerado pelo sistema pode vincular diretamente ao registro bancário original. Se houver uma discrepância, é possível identificar qual transformação introduziu o erro. Sem esse mecanismo, a organização fica dependente de documentação manual que costuma estar desatualizada ou incompleta.
Orquestração e automação com AWS Glue
AWS Glue oferece uma plataforma completa para orquestrar tarefas de processamento de dados em larga escala. A solução permite a definição visual de pipelines através de interfaces gráficas que simplificam a criação inicial de fluxos complexos. Por outro lado, o desenvolvedor pode escrever scripts personalizados quando as necessidades do negócio exigem lógicas específicas.
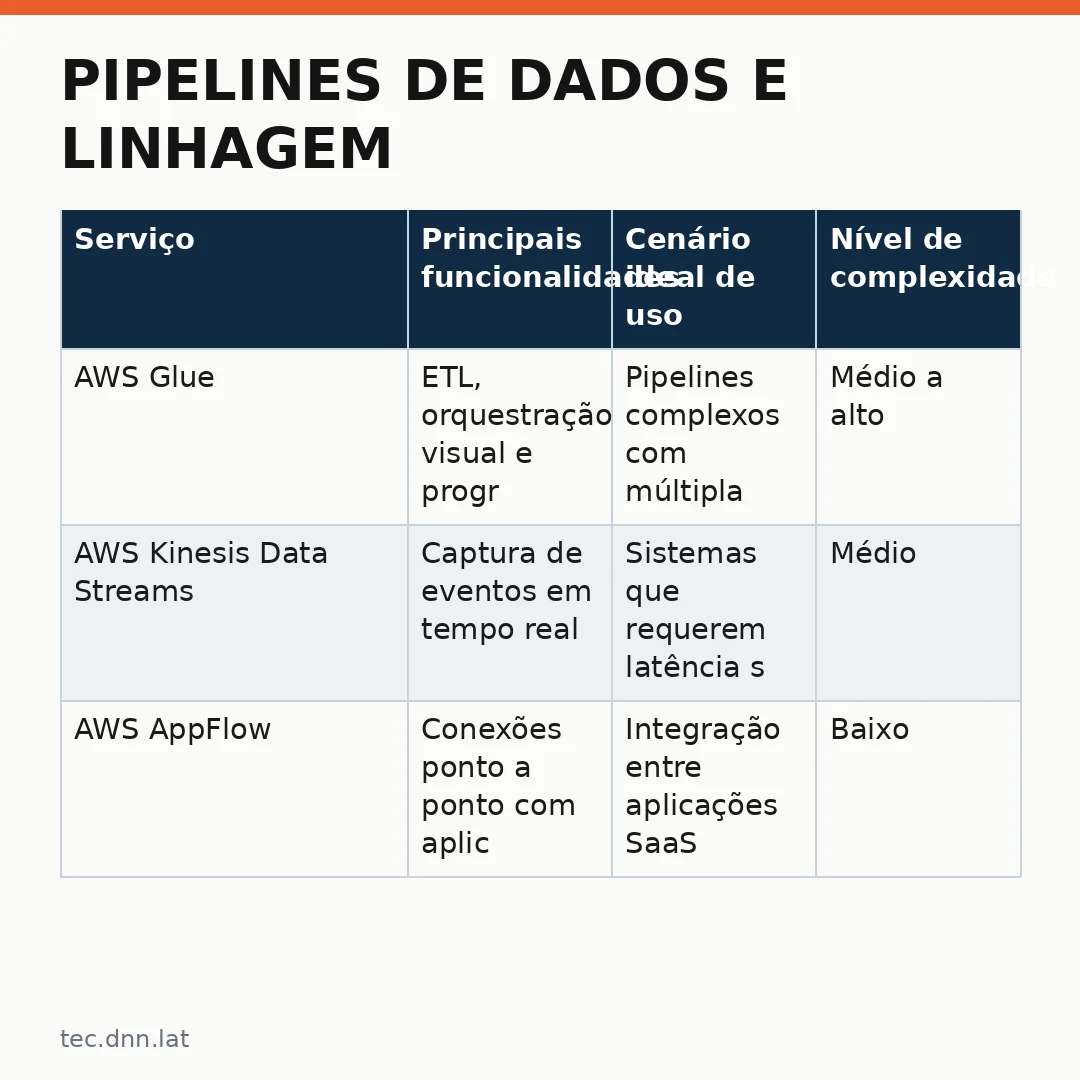
A tabela abaixo compara os principais serviços da AWS voltados para construção de pipelines:
| Serviço | Principais funcionalidades | Cenário ideal de uso | Nível de complexidade |
|---|---|---|---|
| AWS Glue | ETL, orquestração visual e programação declarativa com scripts Python/Scala | Pipelines complexos com múltiplas fontes e transformações | Médio a alto |
| AWS Kinesis Data Streams | Captura de eventos em tempo real, buffer distribuído para processamento assíncrono | Sistemas que requerem latência sub-segundo entre produção e consumo | Médio |
| AWS AppFlow | Conexões ponto a ponto com aplicações de nuvem nativas como Salesforce, SAP e Google Sheets | Integração entre aplicações SaaS sem necessidade de código customizado | Baixo |
| AWS DataSync | Transferência de dados entre locais físicos e na nuvem com monitoramento automático de integridade | Sincronização periódica de repositórios locais para data lakes em S3 | Baixo |
Gestão de custos e otimização de recursos computacionais
A AWS fornece modelos de precificação flexíveis que permitem ajustar o gasto conforme a demanda real do pipeline. Um exemplo prático é o uso de instâncias spot para tarefas não críticas como processamento de batch noturno. Por outro lado, manter instâncias sobrecarregadas ou com memória subutilizada aumenta desnecessariamente o custo operacional.
Inclusive, os serviços gerenciados da AWS eliminam a necessidade de provisionar infraestrutura manualmente. O Glue cobra por hora de execução e por quantidade de dados processados, enquanto Lambda segue modelo pay-per-execution. Essa granularidade permite dimensionar cada componente conforme sua importância dentro do pipeline como um todo.
No entanto, a falta de monitoramento contínuo pode levar ao desperdício silencioso de recursos. Uma instância que fica ociosa durante horas ou minutos contribui para custos desnecessários. Por conseguinte, é fundamental configurar alarmes e alertas quando métricas como uso de CPU ou memória atingem limites pré-definidos.
Observabilidade e monitoramento de pipelines
A observabilidade adequada permite identificar gargalos antes que eles afetem a produção. AWS CloudWatch fornece coletadores de métricas nativos para os serviços da plataforma, mas também é possível instalar agentes em aplicações customizadas. Ademais, o Amazon Managed Service for Apache Flink oferece processamento de streaming com monitoramento embutido.
A tabela a seguir destaca recursos de observabilidade disponíveis na AWS:
| Serviço | Métricas principais disponíveis | Ferramentas integradas | Cenário de uso recomendado |
|---|---|---|---|
| AWS CloudWatch | Métricas personalizadas, logs, traços distribuídos através do X-Ray integrado | X-Ray para correlação de traces entre serviços | Geral: monitoramento de qualquer componente da infraestrutura AWS |
| AWS Managed Service for Apache Flink | Métricas específicas de streaming, latência e throughput do pipeline de dados | Sensor Streams para detecção automática de anomalias em fluxo de tempo real | Pipelines de stream processing com requisitos de baixa latência |
| AWS Glue Development Endpoint | Métricas específicas da execução dos jobs do Glue e consumo de recursos | Separação de ambiente de desenvolvimento, testes e produção com tags automaticas | Desenvolvimento de pipelines ETL complexos com múltiplos jobs interdependentes |
É importante notar que a observabilidade não pode ser uma reflexão tardia. Deve-se planejar quais métricas serão coletadas desde o início do projeto e definir alertas críticos antes de colocar o sistema em produção. Por outro lado, excesso de dados monitorados também gera custo adicional sem agregar valor prático à operação.
Considerações sobre segurança e governança
A AWS oferece ferramentas nativas para criptografia de dados em repouso e em trânsito dentro dos pipelines. A Amazon KMS permite a definição de políticas granulares sobre quem tem acesso às chaves de criptografia usadas em cada pipeline. Além disso, o Lake Formation fornece controle de acesso baseado em atributos que se integra com diretórios da organização.
Quando um agente de IA consome dados sensíveis como e-mails ou registros médicos, é necessário garantir que cada transformação preserve a conformidade regulatória. A AWS Identity Manager centraliza essas políticas em um único console. Todavia, essa centralização exige configuração cuidadosa para não restringir excessivamente o acesso dos operadores durante a operação do dia a dia.
Por fim, vale destacar que pipelines de dados e linhagem formam um sistema coeso que precisa ser tratado como infraestrutura crítica da organização. A AWS fornece todos os componentes necessários, mas cabe à equipe definir as políticas de governança desde o início para evitar retrabalho futuro. Quando implementado com disciplina, esse ecossistema sustenta agentes de IA capazes de entregar valor real ao negócio sem comprometer a confiabilidade das decisões que tomam.
Leia tambem
- Apple lidera marcas valiosas do mundo, mas aposta na inteligência artificial para manter liderança (tec.pnn.lat)
- Agentes de Saúde em Brasília: Conheça Profissionais que Transformam Vidas no Sistema Único (saude.dnn.lat)
- iFood Lança Inteligência Artificial para Restaurantes Vendem Mais no WhatsApp (dnn.lat)
- Melhor fone Pulse 10: Os modelos mais recomendados por especialistas em áudio para 2026 (tec.dnn.lat)
- Grande Acusações de Colusão: Grupo Acusa Tech Gigantes de Paralisar a IA (tec.dnn.lat)

One thought on “Pipelines de dados e linhagem: o que sustenta um agente de IA preciso na AWS — guia para quem implementa no negócio”
Comments are closed.