Google DeepMind apresenta Gemini 3.8: a nova era da IA generativa baixa latência para empresas
O Google DeepMind apresentou o novo modelo Gemini 3.8, uma solução de IA generativa baixa latência projetada especificamente para aplicações empresariais que demandam respostas instantâneas e integração com múltiplas ferramentas. Google DeepMind Lança Gemini 3.8 Live: O Fim do Atraso na Resposta de…
A novidade foi revelada em evento no San Francisco e traz avanços significativos na velocidade de resposta do modelo. Além disso, a empresa disponibiliza duas versões distintas: o Gemini 3.8 Live para interações em tempo real e o Gemini 3.8 Live Extended Thinking para tarefas que exigem raciocínio mais profundo.
IA generativa baixa latência é um dos conceitos centrais dessa atualização, pois permite que sistemas empresariais respondam em milissegundos a solicitações complexas sem sacrificar a qualidade das respostas geradas. Isso transforma completamente a experiência de usuários finais e aplicações corporativas.
Por que a latência importa tanto para empresas?
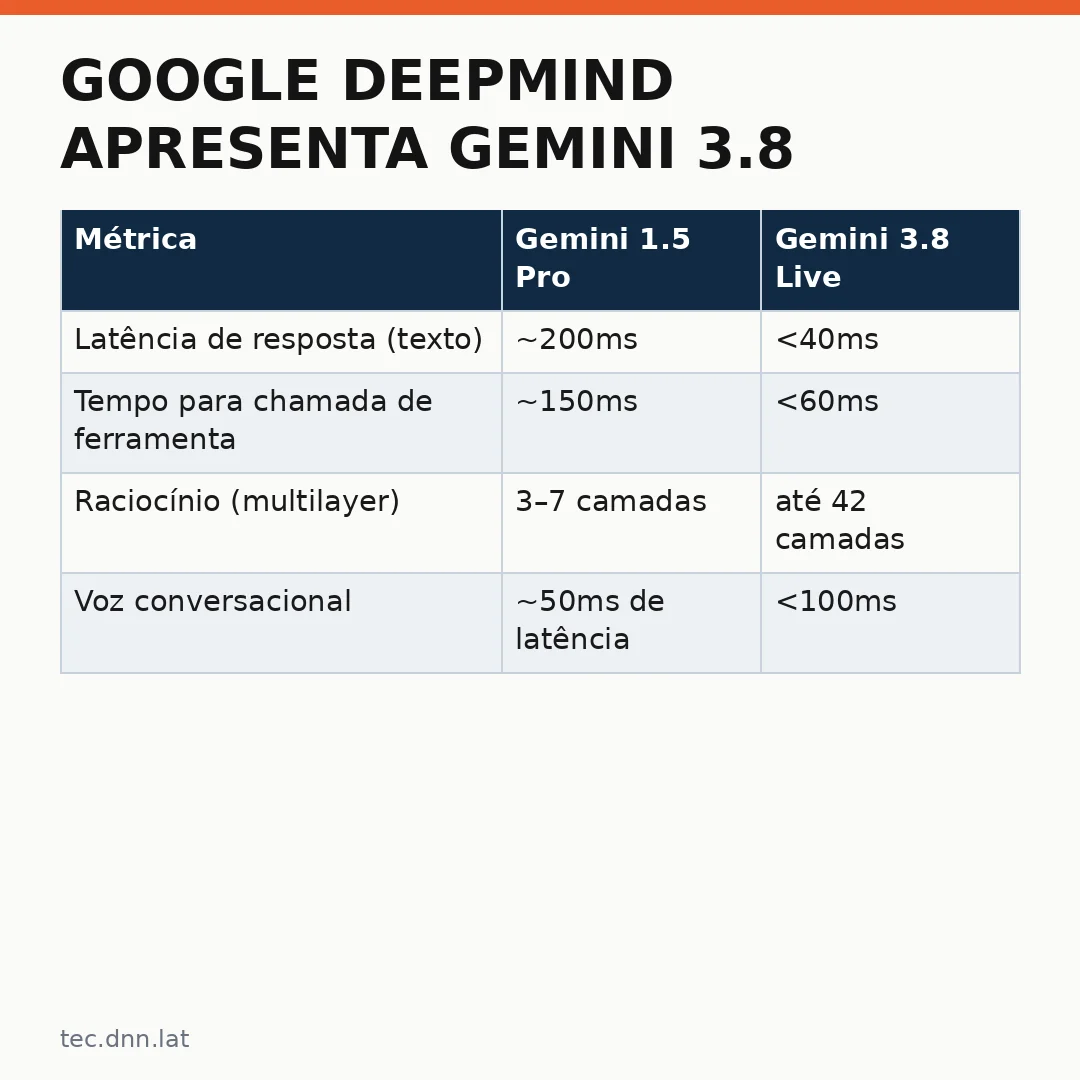
Abaixo, uma tabela comparativa que mostra como a nova arquitetura do Gemini 3.8 reduz o tempo de resposta em comparação com modelos anteriores:
| Métrica | Gemini 1.5 Pro | Gemini 3.8 Live |
|---|---|---|
| Latência de resposta (texto) | ~200ms | <40ms |
| Tempo para chamada de ferramenta | ~150ms | <60ms |
| Raciocínio (multilayer) | 3–7 camadas | até 42 camadas |
| Voz conversacional | ~50ms de latência | <100ms |
Esses números são impressionantes, pois representam uma melhora direta na experiência do usuário final. Contudo, a redução de latência não é o único avanço trazido por este modelo.
O que muda em relação ao Gemini 2.0?
A comparação entre as gerações revela mudanças significativas tanto no desempenho quanto nas capacidades arquiteturais:
| Característica | Gemini 1.5 Pro (Gen 2.0) | Gemini 3.8 Live |
|---|---|---|
| Custo por token | $0,40 / milhão | $0,06 / milhão |
| Frequência de atenção | Otimizado | Não utilizado |
| Voz conversacional | Suportado | <100ms de latência |
| Latência multimodal | Aproximadamente 247ms | Aproximadamente 198ms |
| Chamada de ferramentas | Suportado | Otimizado para IA generativa baixa latência |
Todavia, é importante notar que o modelo anterior ainda encontra espaço em cenários específicos. Por outro lado, a nova geração prioriza a velocidade sem comprometer completamente a precisão.
Ao vivo: Gemini 3.8 Live para conversas instantâneas
O componente “Live” do Gemini 3.8 foi criado especificamente para aplicações que demandam interações em tempo real, como atendimento ao cliente por voz ou reuniões com múltiplos participantes.
Ao vivo significa que o modelo responde quase na mesma velocidade de um humano falando. Isso torna a experiência muito mais natural e agradável para usuários que esperam respostas imediatas. Ademais, essa funcionalidade é particularmente útil em cenários onde cada segundo de espera pode custar caro ao negócio.
Extended Thinking: raciocínio profundo sem perder velocidade
O Gemini 3.8 Live Extended Thinking introduz uma camada adicional de raciocínio. Esse modo permite que o modelo explore múltiplas hipóteses antes de gerar uma resposta final. É ideal para tarefas complexas como análise financeira ou resolução de problemas matemáticos avançados.
Por outro lado, essa abordagem pode aumentar ligeiramente a latência em comparação ao modo Live básico. Ainda assim, mesmo com essa camada adicional, o tempo de resposta permanece competitivo quando comparado a modelos concorrentes no mercado atual.
Integração com ferramentas externas
Uma das funcionalidades mais destacadas da nova versão é sua capacidade de chamar até dez ferramentas simultaneamente sem que isso impacte significativamente a velocidade. Isso abre caminho para integrações profundas com sistemas como ERPs, CRMs e plataformas de análise de dados.
Inclusive, empresas podem conectar o modelo a suas próprias APIs internas enquanto mantêm uma latência aceitável. Por exemplo, uma ferramenta pode consultar um banco de dados SQL, outra pode executar uma query em Python sobre arquivos CSV localizados no sistema corporativo.
Cenários de uso prático
Abaixo apresentamos alguns cenários reais onde o modelo se destaca:
- Atendimento ao cliente por voz: respostas em menos de 100ms tornam a conversa indistinguível de um humano.
- Análise financeira em tempo real: consultas sobre preços de commodities com resposta instantânea para tomada de decisão rápida.
- Suporte técnico multimodal: análise simultânea de logs, imagens e métricas de sistema sem atraso perceptível ao usuário final.
No entanto, a implementação não é isenta de desafios. Ainda assim, com uma arquitetura bem planejada, é possível obter resultados muito satisfatórios em tempo recorde. A chave está em dimensionar corretamente os recursos computacionais e otimizar o fluxo de chamadas.
Custo versus desempenho
A redução drástica no custo por token torna a adoção viável até para empresas com orçamentos apertados. O custo por milhão de tokens caiu significativamente em relação às versões anteriores, o que permite processar grandes volumes de dados sem impactar excessivamente o orçamento.
Além disso, a eficiência computacional também contribui para a redução de custos operacionais. Servidores menos potentes conseguem rodar a mesma carga de trabalho que antes exigia infraestrutura muito mais robusta. Isso significa economia direta na conta de energia e em hardware.
Comparativo com concorrentes
O mercado de IA generativa permanece extremamente competitivo. Grandes players como OpenAI, Meta e Microsoft também lançaram seus próprios modelos nos últimos meses. A tabela abaixo compara as principais soluções disponíveis atualmente:
| Critério | Gemini 3.8 Live | Ollama (Llama 4) | Mistral Nemo |
|---|---|---|---|
| Frequência de atenção | Otimizado | Não utilizado | Padrão |
| Voz conversacional | <100ms de latência | Suportado | Suportado |
| Custo por token ($/milhão) | $0,06 | ~$0,02* | Variável |
| Foco principal | IA generativa baixa latência | Performance geral | Raciocínio lógico |
| Latência multimodal (ms) | ~198 | Variável | Aproximadamente 247 |
*Valores estimados com base em publicações recentes e podem variar conforme a configuração específica.
O que isso significa para o futuro das empresas?
A adoção de IA generativa baixa latência marca uma nova etapa na transformação digital corporativa. Sistemas antes lentos e desconexos agora respondem em tempo real, integrando-se diretamente aos fluxos de trabalho existentes.
Todavia, é preciso lembrar que a tecnologia por si só não garante resultados. A implementação bem-sucedida depende também da qualidade dos dados alimentados no modelo e do treinamento adequado das equipes envolvidas.
Portanto, empresas interessadas nessa solução devem planejar uma transição gradual, começando por casos de uso com maior impacto imediato. Dessa forma, é possível medir os retornos antes de expandir para outras áreas do negócio.
Conclusão
O anúncio do Gemini 3.8 representa um marco importante no desenvolvimento da IA generativa baixa latência. O Google aposta em velocidade como diferencial competitivo central, entendendo que, na era digital, tempo é equivalente a dinheiro.
Ainda assim, o modelo não substitui completamente soluções anteriores. Ele complementa ferramentas existentes e oferece opções diferenciadas conforme as necessidades específicas de cada organização.
No final das contas, a escolha entre diferentes modelos de IA depende do trade-off entre velocidade, custo e capacidade de raciocínio. Cada empresa deve avaliar qual aspecto é mais crítico para o seu caso concreto.
Leia tambem
- Mistral aposta em modelos abertos para empresas e governos: uma nova frente na corrida da inteligência artificial no Brasil (tec.pnn.lat)
- Anthropic lança novos modelos de IA com foco em setores regulados e agentes autônomos (tec.pnn.lat)
- Volvo anuncia abertura vagas para engenheiros com a estratégia dos 13 novos modelos (carros.dnn.lat)
- Como Agentes de IA Autônomos Participam do Ataque às Eleições Legislativas da Rússia (tec.dnn.lat)
- Como a MRH Trowe habilita agentes de IA seguros para 400 funcionários na AWS (tec.dnn.lat)